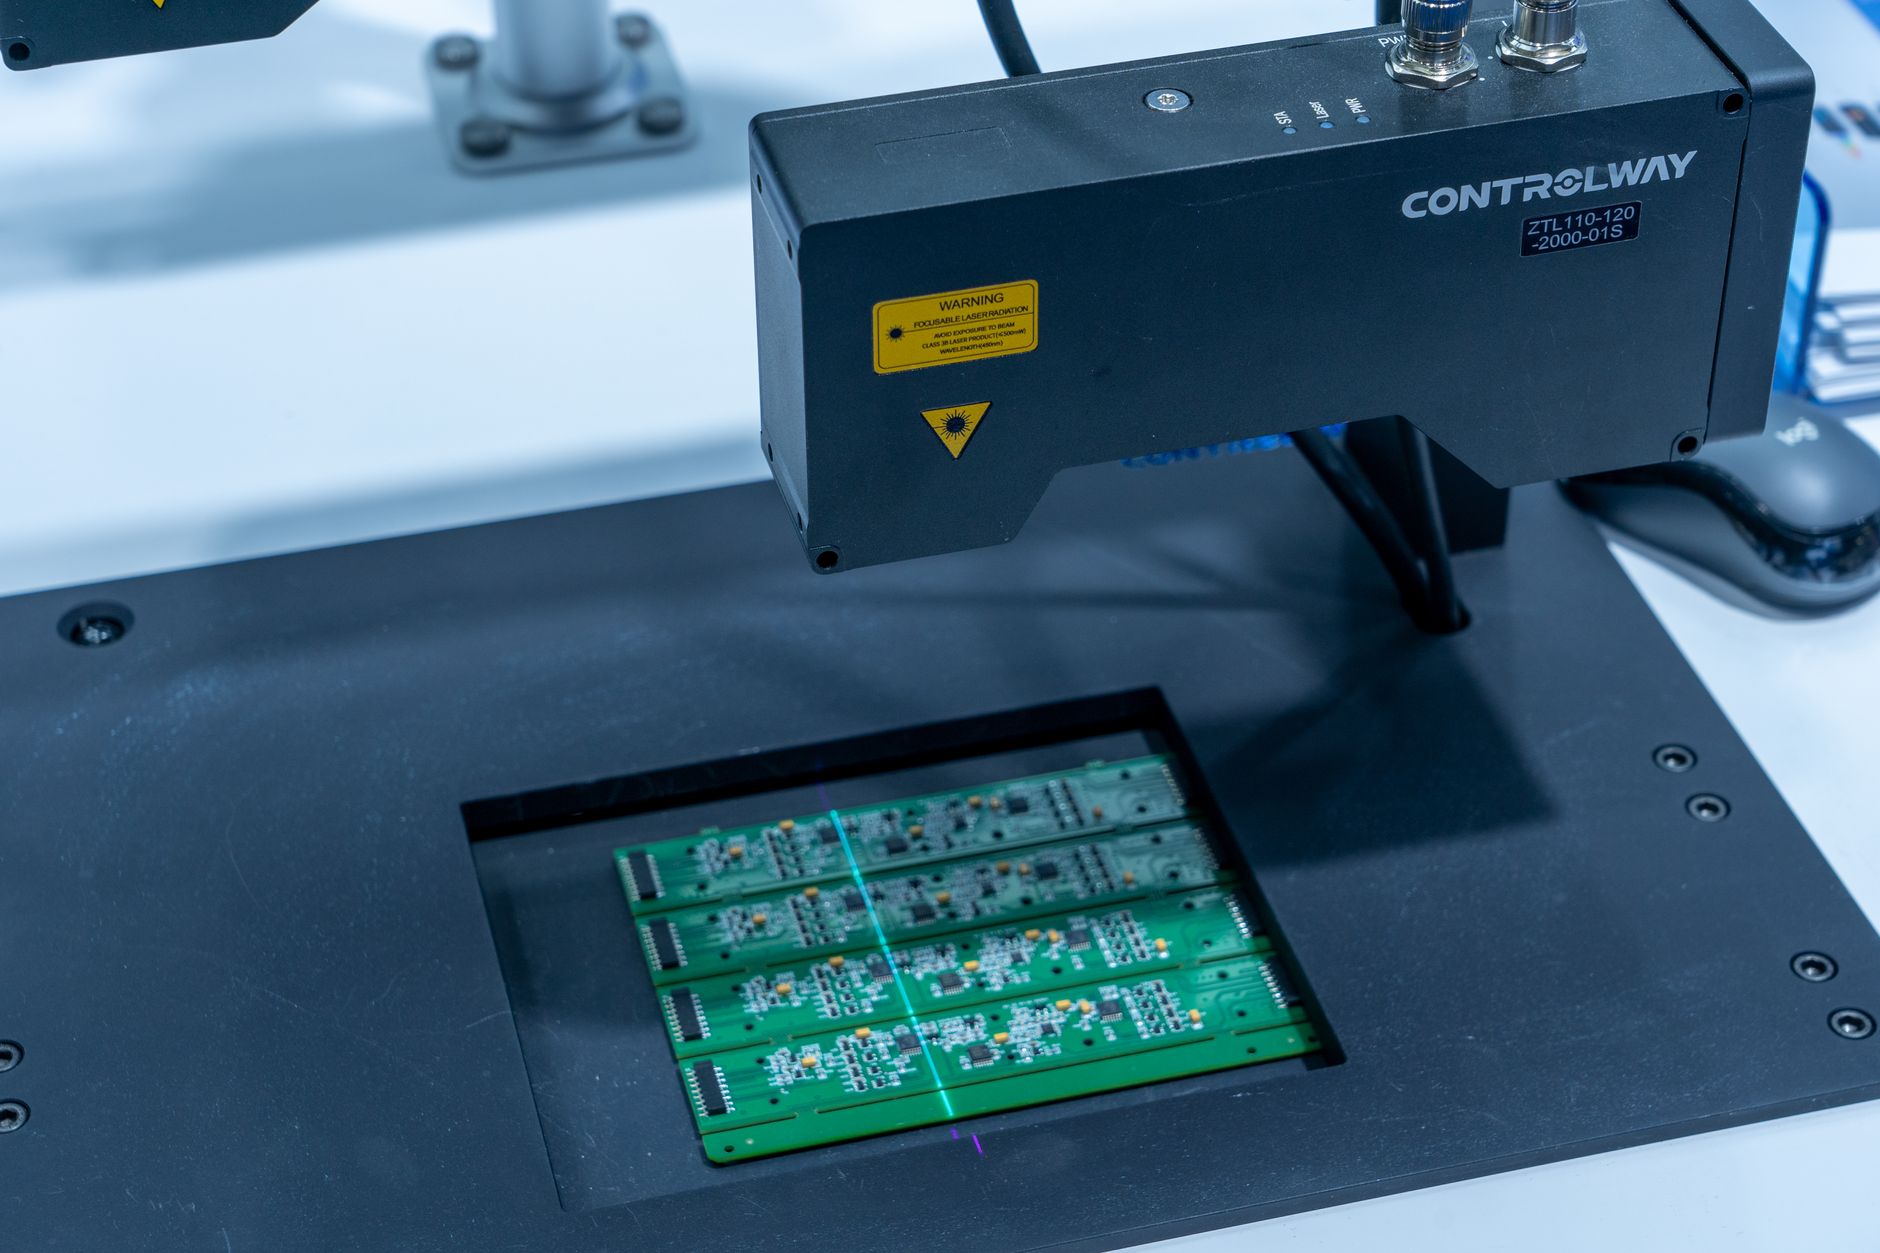
Gdzie analizować obraz z kamery i dane z czujników, jeśli decyzja ma wrócić na linię zanim detal minie stanowisko, a jednocześnie zespół jakości chce porównywać wady między zmianami i zakładami? To nie jest wybór „nowoczesnej technologii”, tylko decyzja o miejscu, w którym powstaje sygnał sterujący procesem. Edge AI oznacza analizę blisko maszyny, kamery, sterownika albo lokalnego serwera na hali. Chmura to analiza w zdalnej, centralnie zarządzanej infrastrukturze. Hybryda rozdziela te role: decyzje operacyjne zostają przy procesie, a trenowanie modeli, raporty i porównania między liniami idą tam, gdzie łatwiej łączyć dane z wielu źródeł.
Miejsce uruchomienia modelu przesądza też o ciągłości działania, transferze danych, aktualizacjach i integracji z warstwą OT. System, który odrzuca wadliwy detal, nie może czekać na to, aż wróci odpowiedź z zewnątrz, jeśli okno na reakcję zamyka się wraz z ruchem przenośnika. Z kolei model uczony wyłącznie na jednej linii szybko traci sens, gdy receptura, oświetlenie albo dostawca komponentu zmieniają się w innym zakładzie. Krótki obraz tej różnicy: system wizyjny może odrzucić wadliwy detal przy linii, a do chmury wysłać tylko próbki wad, metadane i wskaźniki jakości. Zanim padnie wybór architektury, trzeba ustalić, czy przypadek wymaga natychmiastowej reakcji na hali, czy przede wszystkim porównywania danych między liniami, zmianami i zakładami.
Co sprawdzić: czy wynik analizy ma zatrzymać maszynę, odrzucić detal albo uruchomić alarm w tym samym cyklu, czy służy głównie do przeglądu po zmianie.
Edge AI czy chmura: decyzja, która wpływa na sam proces produkcyjny
Kamera wykrywa rysę albo czujnik drgań sygnalizuje anomalię. Sama detekcja nie ma jeszcze wartości produkcyjnej. Wartość pojawia się dopiero wtedy, gdy sygnał dotrze do człowieka albo do urządzenia wykonawczego w czasie, w którym da się jeszcze coś zrobić: odseparować sztukę, zwolnić posuw, wezwać utrzymanie ruchu albo zatrzymać niebezpieczny ruch. Jeśli ta droga jest za długa, model może być trafny, a proces i tak poniesie stratę.
Edge AI w przemyśle to nie „mały komputer z modelem”. To świadome skrócenie ścieżki między źródłem danych a skutkiem. Analiza obrazu na brzegu sieci odbywa się przy kamerze, w komputerze przemysłowym szafy sterowniczej albo na serwerze zakładu, bez konieczności wysyłania pełnego strumienia poza fabrykę. Chmura dla fabryki daje coś innego: wspólną przestrzeń do trenowania, porównywania partii, wersjonowania modeli i raportowania dla kilku lokalizacji. Oba miejsca mogą współistnieć, ale nie pełnią tej samej roli w cyklu produkcyjnym.
Typowy błąd polega na traktowaniu lokalizacji modelu jak szczegółu wdrożeniowego, który „da się poprawić później”. Później okazuje się, że PLC oczekuje odpowiedzi w oknie cyklu, łącze zakładowe nie uniesie surowego wideo, a polityka bezpieczeństwa nie pozwala wypuszczać obrazu stanowiska na zewnątrz. Wtedy projekt nie potrzebuje lepszego algorytmu, tylko innej architektury.
Trzy role, które trzeba rozdzielić zanim padnie nazwa platformy
Pierwsza rola to decyzja w cyklu: obecność komponentu, pozycja detalu, wada powierzchniowa, przekroczenie progu drgań. Druga to doskonalenie modelu: zbieranie trudnych przypadków, etykietowanie, ponowne uczenie, test na danych z innej zmiany. Trzecia to obraz dla zarządzania: trendy braków, porównanie linii, ślad dla klienta albo raport ESG oparty na zagregowanych wskaźnikach, nie na surowym strumieniu z kamery.
Edge computing w produkcji naturalnie bierze pierwszą rolę. Chmura lepiej znosi drugą i trzecią, o ile dane są opisane tymi samymi identyfikatorami procesu. Hybrydowa architektura AI nie jest kompromisem „dla wszystkich”. Jest skutkiem tego, że te trzy role mają inny czas, inny wolumen i inną wrażliwość.
Gdzie kończy się IT, a zaczyna odpowiedzialność za linię
Gdy model tylko podpowiada operatorowi, awaria łącza jest niedogodnością. Gdy model steruje wyrzutnikiem albo blokadą, awaria łącza staje się zatrzymaniem albo — gorzej — cichym pominięciem kontroli. Dlatego wybór Edge AI czy chmura jest jednocześnie wyborem tego, kto odpowiada za działanie przy braku internetu, kto zatwierdza nową wersję modelu i kto ma prawo zmienić próg alarmu w trakcie zmiany.
Co sprawdzić: właściciela decyzji operacyjnej, właściciela modelu i właściciela danych. Jeśli to trzy różne zespoły bez wspólnej procedury wydania wersji, architektura zacznie się rozjeżdżać niezależnie od miejsca obliczeń.
Krok 1. Zacznij od czasu reakcji i krytyczności decyzji
Krok 1 nie polega na mierzeniu „szybkości AI”. Polega na opisaniu, co ma się wydarzyć po wykryciu i jaki jest koszt spóźnienia. Ta sama kamera może zasilać trzy różne zastosowania: podpowiedź dla operatora, sygnał do układu wykonawczego i materiał do raportu jakości. Każde z nich toleruje inny czas odpowiedzi.
Gdy opóźnienie staje się problemem produkcyjnym
Analiza wspierająca operatora może poczekać sekundę albo dwie, jeśli człowiek i tak ocenia obraz na monitorze. Analiza sterująca procesem musi zmieścić się w oknie ruchu maszyny: od akwizycji klatki albo próbki, przez inferencję, po komendę dla PLC, wyrzutnika albo napędu. Analiza do raportowania może trwać minuty, a nawet godziny, bo jej odbiorcą jest przegląd zmiany, nie takt linii.
Im krótsze okno decyzyjne i im większy koszt błędu — odpad, zatrzymanie, ryzyko dla człowieka, wada ukryta u klienta — tym silniejszy argument za przetwarzaniem lokalnym. Kontrola obecności komponentu, wykrywanie defektów w ruchu, alarmy bezpieczeństwa oraz reakcja na nietypowe drgania albo temperaturę urządzenia należą do tej grupy. Tu AI wizyjne na linii produkcyjnej przegrywa nie wtedy, gdy model się myli, lecz wtedy, gdy dobra odpowiedź przychodzi po tym, jak detal już pojechał dalej.
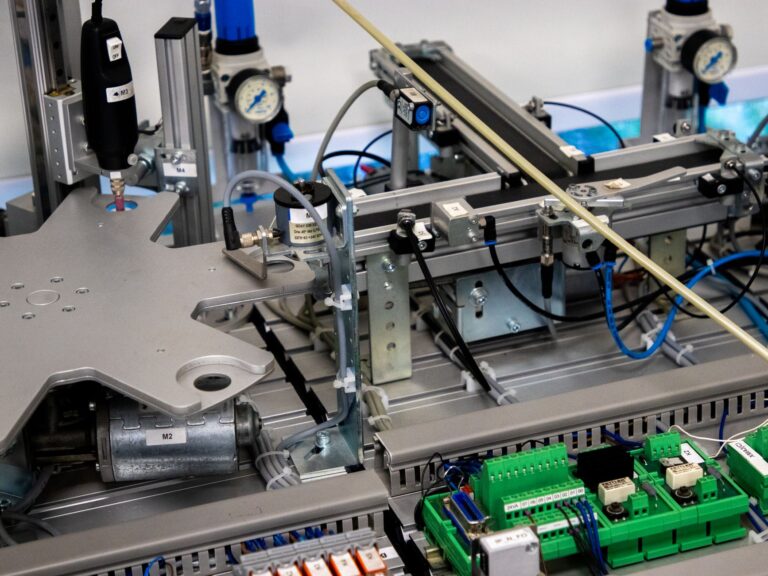
Inaczej wyglądają zastosowania, które dobrze znoszą chmurę. Analiza trendów jakościowych, porównywanie wydajności zakładów, wyszukiwanie powtarzalnych problemów z wielu tygodni i raporty dla kierownictwa nie wymagają odpowiedzi w cyklu maszyny. Opóźnienia w systemach przemysłowych bolą dopiero wtedy, gdy ktoś próbuje wcisnąć te wolniejsze analizy w tę samą ścieżkę co sterowanie.
Nie oceniaj opóźnienia wyłącznie czasem inferencji modelu. Liczy się cała droga: akwizycja, kolejka, transmisja, buforowanie, integracja z systemem wykonawczym i fizyczna reakcja urządzenia. Model może zwrócić wynik w ułamku sekundy, a i tak przegrać z opóźnieniem sieci, oczekiwaniem na potwierdzenie z MES albo z mechanizmem, który potrzebuje własnego czasu na ruch.
Jak rozpisać okno decyzyjne bez zgadywania milisekund
Zacznij od taktu i od punktu, w którym interwencja jeszcze coś zmienia. Przy kontroli wizyjnej tym punktem bywa stanowisko odrzutu, nie moment zrobienia zdjęcia. Przy danych z czujników IIoT tym punktem bywa próg, po którym łożysko albo silnik wchodzi w stan, którego nie da się już bezpiecznie „dociągnąć do końca zmiany”. Jeśli tego punktu nie ma na schemacie, dyskusja o chmurze i brzegu sieci jest przedwczesna.
Rozdziel też błąd na dwie strony. Fałszywy alarm zatrzymuje dobrą sztukę albo wzywa utrzymanie ruchu bez potrzeby. Pominięcie wady puszcza złą sztukę dalej. Przy sterowaniu lokalnym oba błędy są widoczne od razu i da się je powiązać z wersją modelu oraz z warunkami linii. Przy analizie zdalnej łatwo pomylić błąd modelu z opóźnieniem albo z luką w danych.
Typowy błąd na tym kroku
Częsty błąd to uśrednienie „akceptowalnego opóźnienia” dla całego projektu. Jedna liczba nie opisuje jednocześnie wyrzutnika, pulpitu operatora i miesięcznego raportu braków. Drugi błąd to test na próbce offline, bez podłączenia do rzeczywistej ścieżki wykonawczej. Model wygląda wtedy szybko, a linia i tak czeka na integrację, której nikt nie wliczył w czas reakcji.
Co sprawdzić: pełną drogę sygnału — od kamery lub czujnika, przez model, po alarm, system MES, PLC albo mechanizm odrzutu. Zapisz, który odcinek jest lokalny, który zależy od sieci zakładowej, a który od łącza na zewnątrz.
Krok 2. Oceń, jakie dane powstają na hali i które z nich naprawdę trzeba przesyłać
Krok 2 zaczyna się od inwentaryzacji, nie od wyboru brokera danych. Na hali powstają strumienie o zupełnie różnej wadze. Obraz, szeregi czasowe i kontekst procesu nie powinny jechać tą samą autostradą tylko dlatego, że „wszystko jest danymi do AI”.
Obraz, sygnały czasowe i dane kontekstowe nie mają tej samej charakterystyki
Obraz z kamer przemysłowych jest najbardziej wymagający objętościowo. Liczy się nie tylko rozdzielczość, ale liczba klatek, liczba kamer, czas przechowywania i to, czy do analizy potrzebny jest surowy materiał, czy wystarczy klatka w momencie zdarzenia. Stabilny przesył pełnego strumienia poza zakład bywa droższy i bardziej kruchy niż sama inferencja. Przy kontroli jakości z AI często wystarczy decyzja lokalna plus krótki wycinek wokół wady.
Dane z czujników wyglądają lekko, dopóki nie policzysz częstotliwości próbkowania i liczby punktów. Drgania, prąd, ciśnienie albo temperatura w wielu miejscach, zbierane bez agregacji, potrafią zapełnić magazyn szybciej niż klatki z jednej kamery. Dodatkowo pojedynczy sygnał rzadko wystarcza. Predykcyjne utrzymanie ruchu wymaga korelacji kilku kanałów z obciążeniem, recepturą i stanem maszyny. Bez tego „anomalia” jest tylko odchyleniem liczby, nie diagnozą.
Dane kontekstowe decydują o tym, czy model w ogóle ma prawo porównywać dwie obserwacje. Numer partii, receptura, typ produktu, parametry maszyny, zmiana i status alarmów tłumaczą, dlaczego ten sam obraz albo ten sam poziom drgań raz jest normą, a raz odchyłką. Brak kontekstu psuje zarówno Edge AI, jak i analizę w chmurze. Różnica polega na tym, że w chmurze błąd kontekstu skaluje się na wiele zakładów naraz.
Brzeg sieci dobrze sprawdza się jako filtr. Lokalnie wykrywasz zdarzenie, agregujesz sygnał, odcinaś to, czego nie wolno wynosić, i wysyłasz fragment potrzebny do poprawy modelu. Chmura ma sens jako miejsce łączenia źródeł, ale tylko wtedy, gdy identyfikatory procesu są spójne. Inaczej centralny zbiór staje się magazynem nieporównywalnych plików.
Zamiast stale wysyłać pełny strumień z kamery, system może trzymać materiał lokalnie w oknie wokół anomalii i przekazywać do centralnej analizy wybrane przypadki: potwierdzone wady, fałszywe alarmy i próbki z nowej receptury. Surowy zapis zostaje tam, gdzie powstał, dopóki ktoś nie wykaże, że jest potrzebny po podjęciu decyzji lokalnej.
Retencja, łącze i prawo do surowego materiału
Ustal osobno, jak długo obraz i próbki czujników mają zostać na linii, jak długo w archiwum zakładu i czy w ogóle mogą opuścić teren. Czasem powód jest operacyjny: reklamacja klienta wraca po tygodniach i trzeba odtworzyć klatkę. Czasem powód jest organizacyjny: obraz stanowiska pokazuje układ narzędzi albo twarze pracowników i nie powinien trafiać do ogólnego jeziora danych.
Przy planowaniu kolejnych kroków pomocny może być tekst: Generatywne raporty ESG z danych procesowych.
Łącze oceniaj w warunkach zmiany, nie w teście nocnym. Szczyt zrzutu logów, backup i kilka kamer w wysokiej rozdzielczości potrafią zderzyć się w tym samym oknie. Jeśli analiza w chmurze ma być warunkiem działania linii, to łącze staje się elementem maszyny. Jeśli analiza w chmurze dotyczy tylko próbek, łącze może być zwyczajnym kanałem doskonalenia.
Typowy błąd na tym kroku
Najczęstszy błąd to wysyłanie wszystkiego „na wszelki wypadek”. Drugi to wysyłanie samych werdyktów modelu, bez próbek, na których da się później wyjaśnić błąd. Pierwsze zapycha łącze i zwiększa ekspozycję danych OT. Drugie uniemożliwia poprawę modelu. Sensowny środek to lokalna decyzja, lokalny bufor surowca i selektywny eksport przypadków, które zmieniają wiedzę o procesie.
Co sprawdzić: wolumen danych na zmianę, realną przepustowość łącza w godzinach produkcji, okres retencji nagrań oraz to, czy surowe dane są jeszcze potrzebne po lokalnej decyzji.
Krok 3. Porównaj architektury pod kątem niezawodności, bezpieczeństwa i utrzymania
Krok 3 przenosi rozmowę z „gdzie szybciej” na „co się stanie, gdy zawiedzie łącze, dysk, model albo człowiek z uprawnieniami”. Niezawodność i bezpieczeństwo danych OT nie są cechą naklejki „edge” albo „cloud”. Są skutkiem tego, jak zaprojektowano awarię, aktualizację i dostęp.
Edge AI: autonomia lokalna, ale również odpowiedzialność za urządzenia
Najmocniejszy argument za Edge AI jest prosty: linia może dalej oceniać obraz i progi czujników, gdy internet poza zakładem przestaje działać. Krótsza ścieżka decyzyjna ogranicza liczbę elementów, które muszą być sprawne w trakcie cyklu. Mniejsza ekspozycja surowych danych poza zakład zmniejsza też powierzchnię, którą trzeba chronić przy każdej klatce i każdej próbce.
Ta autonomia ma jednak cenę, która wychodzi przy drugiej i trzeciej linii, nie przy pilotażu na jednej kamerze. Komputer przemysłowy, akcelerator i lokalny dysk stają się elementami utrzymania ruchu. Kurz w szafie, temperatura, zasilanie, zużycie nośnika i fizyczny dostęp serwisanta decydują o tym, czy model w ogóle wstanie po postoju. Wersja działająca na stanowisku A potrafi rozjechać się ze stanowiskiem B, jeśli aktualizacje jadą „przy okazji” wizyty technika, a nie według wspólnego okna zmian.
Lokalny stan awaryjny też zostaje na hali. Zapełniony bufor, uszkodzony plik modelu albo wygasły certyfikat nie są wtedy ticketem do centrum danych. Są problemem zmiany, która właśnie produkuje. Zanim ktokolwiek porówna oferty, właściciel procesu powinien podpisać, co stanowisko robi w takim momencie: zostaje na ostatniej znanej dobrej wersji, schodzi do progów bez modelu, zatrzymuje podawanie detali albo puszcza partię dalej jako niesprawdzoną. To decyzja jakościowa, nie parametr instalatora.
Chmura porządkuje utrzymanie, ale poszerza skutek jednej pomyłki
Po stronie chmury utrzymanie wygląda spokojniej, dopóki liczy się liczbę konsol, a nie liczbę skutków. Jedna platforma zbiera logi, tożsamości, kopie i historię wydań. Łatwiej zobaczyć, która linia dostała którą wersję, i łatwiej odebrać dostęp osobie, która odeszła z firmy. Dla raportów, porównań między zakładami i doskonalenia modelu to jest realna przewaga: zespół nie jeździ po szafach, żeby sprawdzić, czy plik w ogóle się wgrał.
Ta sama centralizacja zmienia charakter błędu. Zła wersja modelu, zbyt szeroka rola albo pomyłka w mapowaniu identyfikatorów partii nie psuje jednego stanowiska. Psuje porównanie wielu linii naraz i potrafi cofnąć zaufanie do wskaźników, na których oparto przegląd jakości. W środowisku OT dochodzi jeszcze dostęp dostawcy: konto serwisowe do obrazów ze stanowiska jest czymś innym niż konto do zagregowanych wskaźników. Jeśli umowa nie rozdziela tych dwóch rzeczy, „wygoda chmury” staje się stałym tunelem do surowego materiału.
Bezpieczeństwo nie kończy się na szyfrowaniu łącza. Trzeba wiedzieć, kto może pobrać zbiór uczących klatek, kto może wymusić wdrożenie modelu na linię i czy takie działanie zostawia ślad niezależny od konsoli dostawcy. Centralny dziennik ma sens tylko wtedy, gdy zakład potrafi go odczytać po zakończeniu kontraktu, a nie wyłącznie w interfejsie, który znika razem z subskrypcją.
Zaprojektuj zachowanie przy awarii, zanim wybierzesz miejsce obliczeń
Porównanie architektur warto rozpisać na czterech awariach, które w produkcji zdarzają się częściej niż „padł cały system”. Przy utracie łącza na zewnątrz zakładu liczy się nie sam fakt, że inferencja może zostać lokalnie, lecz to, co operator widzi na pulpicie i co trafia do zapisu partii. Jeśli ekran milczy, a wyrzutnik jedzie dalej według starego progu, załoga nie ma jak odróżnić świadomej pracy offline od cichego pominięcia kontroli.
Awaria dysku jest lokalna i brutalnie konkretna. Bufor wokół anomalii, którego nie da się odczytać, uniemożliwia później wyjaśnienie reklamacji, nawet jeśli decyzja w cyklu była poprawna. Dlatego retencja na linii potrzebuje progu zapełnienia, alarmu zanim nośnik odmówi zapisu i reguły, co dzieje się z nowymi zdarzeniami: nadpisywanie najstarszych próbek, zatrzymanie eksportu albo zatrzymanie stanowiska. Chmura tego dylematu nie usuwa. Przenosi go na magazyn, którego limit też się kończy, tylko później i na większej fakturze.
Awaria modelu bywa trudniejsza do zauważenia niż awaria dysku. Plik jest na miejscu, proces żyje, a wyniki systematycznie zjeżdżają po zmianie oświetlenia, receptury albo progu pewności. Tu różnica architektur dotyczy wykrywania, nie samego miejsca inferencji. Na brzegu sieci odchylenie widać przy stanowisku, ale łatwo je zrzucić na „dziwną zmianę”. W chmurze widać je na wielu liniach, ale dopiero wtedy, gdy ktoś porówna werdykty z potwierdzeniami jakości, a nie z samym ruchem zapytań.
Czwarty przypadek to uprawnienia. Technik utrzymania ruchu, inżynier procesu i zewnętrzny serwis nie powinni mieć tego samego klucza do zatrzymania linii, podmiany modelu i wywozu obrazu. Przy Edge AI pokusa jest fizyczna: port w szafie, lokalne konto administratora, pendrive z „poprawką na szybko”. W chmurze pokusa jest organizacyjna: szeroka rola, współdzielone konto integracji, dostęp zostawiony po wdrożeniu. W obu miejscach brak rozdziału ról kończy się tak samo — zmianą, której nikt nie potrafi przypisać do osoby i do wersji.
Aktualizacja modelu jest zmianą procesu, nie plikiem do wgrania
Wydanie modelu powinno przejść tę samą dyscyplinę co zmiana parametru maszyny. Jest numer wersji, zakres linii, okno wdrożenia, osoba akceptująca i sposób powrotu. Edge AI utrudnia to logistycznie, bo urządzeń bywa więcej niż osób, które umieją je bezpiecznie dotknąć. Chmura ułatwia dystrybucję, ale skraca drogę od kliknięcia do skutku na wielu stanowiskach. Żadne z tych miejsc nie zastępuje procedury wydania uzgodnionej między właścicielem linii, właścicielem modelu i właścicielem danych.
Praktycznie warto rozdzielić trzy kanały zmian. Pierwszy to poprawka bezpieczeństwa systemu operacyjnego i bibliotek, która nie rusza progu jakości. Drugi to nowa wersja modelu, którą wolno wypuścić najpierw na jedną zmianę albo jedną referencję produktu. Trzeci to zmiana reguły awaryjnej: co stanowisko robi, gdy model nie wstanie. Mieszanie tych kanałów w jednym pakiecie sprawia, że po problemie nikt nie wie, czy cofać model, system, czy oba naraz.
Dostęp serwisowy też ma mieć datę ważności. Konto potrzebne na rozruch nie powinno zostać na stałe z prawem do obrazu i do sterowania. W architekturze lokalnej oznacza to odebranie haseł z szafy i zamknięcie zdalnego pulpitu po zakończeniu prac. W architekturze chmurowej oznacza to role czasowe, osobny ślad dla odczytu danych i osobny dla wdrożenia modelu. Inaczej audyt po incydencie pokaże tylko, że „ktoś z integracji był zalogowany”.
Odpowiedzialność operacyjna i utrzymaniowa nie pokrywają się same
Przy Edge AI dział produkcji odpowiada za to, że linia podejmuje decyzję w cyklu, a utrzymanie ruchu dostaje dodatkową flotę urządzeń, których nie było w dotychczasowym przeglądzie. Jeśli nikt nie wpisze tych urządzeń do planu części zamiennych, kopii i kontroli temperatury szaf, lokalna autonomia skończy się przy pierwszej awarii nośnika. Zespół danych nie może być jedynym właścicielem sprzętu, do którego nie ma dojścia w trakcie zmiany.
Przy chmurze ciężar przesuwa się w stronę umowy, tożsamości i ciągłości usługi. Produkcja nadal odpowiada za skutek na linii, ale część dźwigni — dostępność platformy, kolejka wdrożeń, retencja w magazynie dostawcy — leży poza zakładem. To da się prowadzić, pod warunkiem że w umowie jest czas reakcji zgodny z krytycznością zastosowania, jasny podział kopii oraz procedura odebrania danych, gdy współpraca się kończy. Bez tego centralne utrzymanie jest wygodne tylko dopóki nic nie spiera się o winę.
Architektura hybrydowa nie rozładowuje tego napięcia automatycznie. Pomaga dopiero wtedy, gdy dla każdego zastosowania wiadomo, która warstwa ma prawo zatrzymać detal, która może tylko ostrzec, a która służy do późniejszego rozliczenia. Model może dojrzewać centralnie, ale wydanie na linię zostaje zmianą zatwierdzaną lokalnie. Raport może powstać w chmurze, ale nie staje się warunkiem taktu. Takie rozdzielenie jest mniej efektowne niż wybór jednej platformy, za to nie zostawia luki między zespołem, który obiecuje wynik, a zespołem, który o trzeciej w nocy stoi przy maszynie.
Na tym etapie decyzja nie brzmi już „edge albo chmura”. Brzmi: które awarie linia ma przetrwać samodzielnie, kto ma prawo zmienić model i gdzie kończy się odpowiedzialność zakładu, a zaczyna odpowiedzialność platformy. Jeśli te trzy odpowiedzi są spisane przy konkretnym stanowisku, miejsce obliczeń wynika z nich samo. Jeśli nie są, każda architektura będzie wyglądać nowocześnie do pierwszej zmiany, której nikt nie objął procedurą.
Najczęściej zadawane pytania (FAQ)
Czym różni się Edge AI od chmury w fabryce?
Edge AI analizuje dane blisko maszyny, kamery, sterownika lub lokalnego serwera. Chmura wykorzystuje zdalną, centralnie zarządzaną infrastrukturę, lepszą do trenowania modeli, raportowania i porównywania danych z wielu lokalizacji.
Kiedy analiza obrazu powinna działać lokalnie?
Przetwarzanie lokalne jest wskazane, gdy wynik ma w tym samym cyklu odrzucić detal, zatrzymać maszynę, uruchomić alarm lub wpłynąć na działanie układu wykonawczego.
Czy pełny strumień z kamer trzeba wysyłać do chmury?
Nie zawsze. W wielu zastosowaniach wystarczy lokalna decyzja oraz przesyłanie do chmury próbek wad, metadanych, krótkich wycinków obrazu i zagregowanych wskaźników jakości.
Do czego najlepiej wykorzystać chmurę w AI przemysłowym?
Chmura dobrze sprawdza się przy zbieraniu trudnych przypadków, etykietowaniu danych, ponownym uczeniu i wersjonowaniu modeli, a także przy porównywaniu linii, zmian i zakładów.
Co należy sprawdzić przed wyborem architektury?
Trzeba określić czas reakcji, koszt spóźnienia, pełną drogę sygnału, rodzaj i objętość danych, zależność od sieci, wymagania bezpieczeństwa oraz właścicieli decyzji, modelu i danych.
Najważniejsze punkty
- Edge AI najlepiej sprawdza się przy decyzjach wymagających krótkiego czasu reakcji i bezpośredniego wpływu na proces.
- Chmura jest naturalnym miejscem dla trenowania modeli, raportowania oraz porównywania danych z wielu linii i zakładów.
- Architektura hybrydowa pozwala pozostawić decyzje operacyjne przy procesie, a do chmury przesyłać dane potrzebne do doskonalenia i zarządzania.
- Przed wyborem rozwiązania trzeba przeanalizować pełną drogę sygnału: od kamery lub czujnika przez model aż po alarm, PLC, MES albo mechanizm odrzutu.
- Nie wszystkie dane z hali trzeba przesyłać w tej samej postaci. Surowy obraz i szeregi czasowe warto zestawić z metadanymi oraz zagregowanymi wskaźnikami.